# Transformer 实战
# 背景
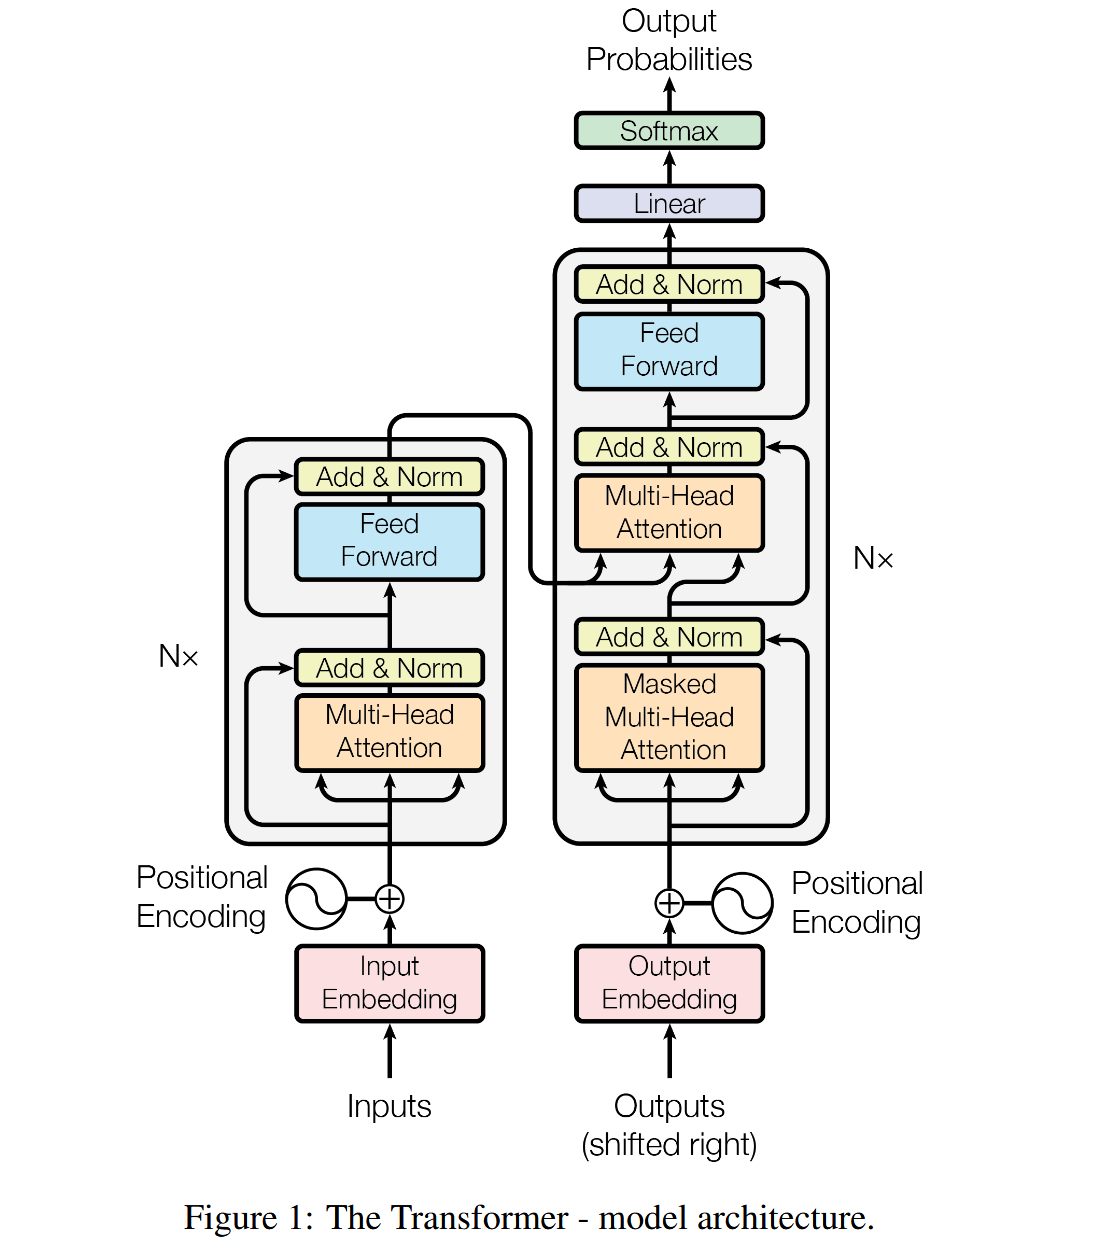
为了解决在序列建模中提升并行与长距离依赖建模能力,摆脱对循环与卷积的依赖。其核心是编码器与解码器结构。
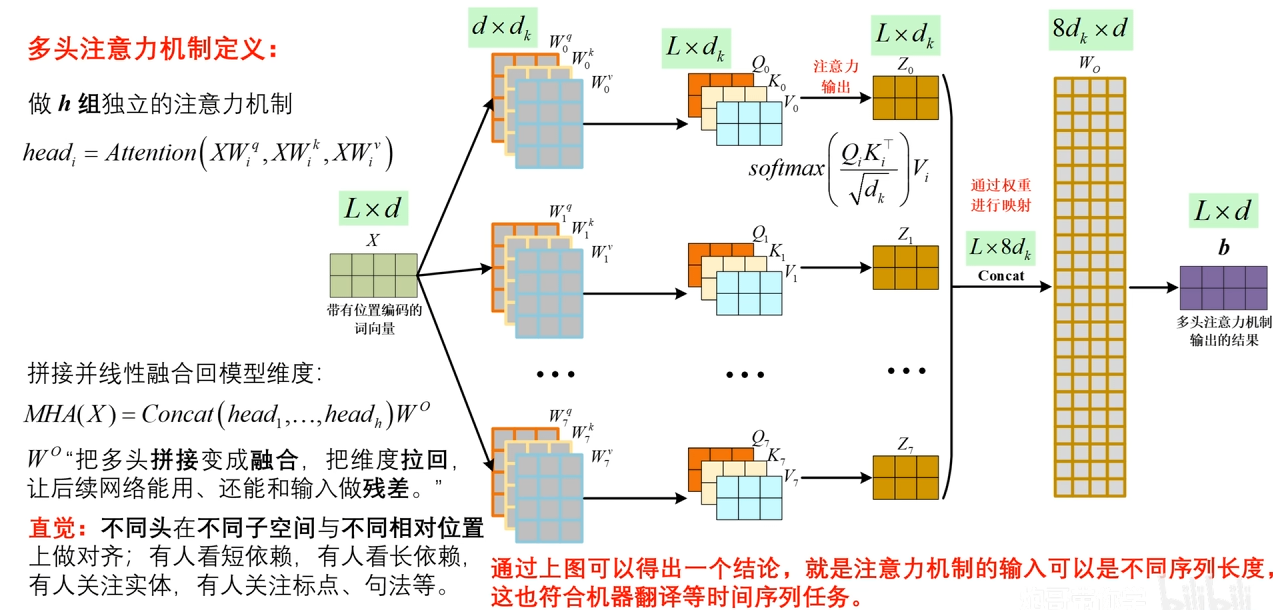
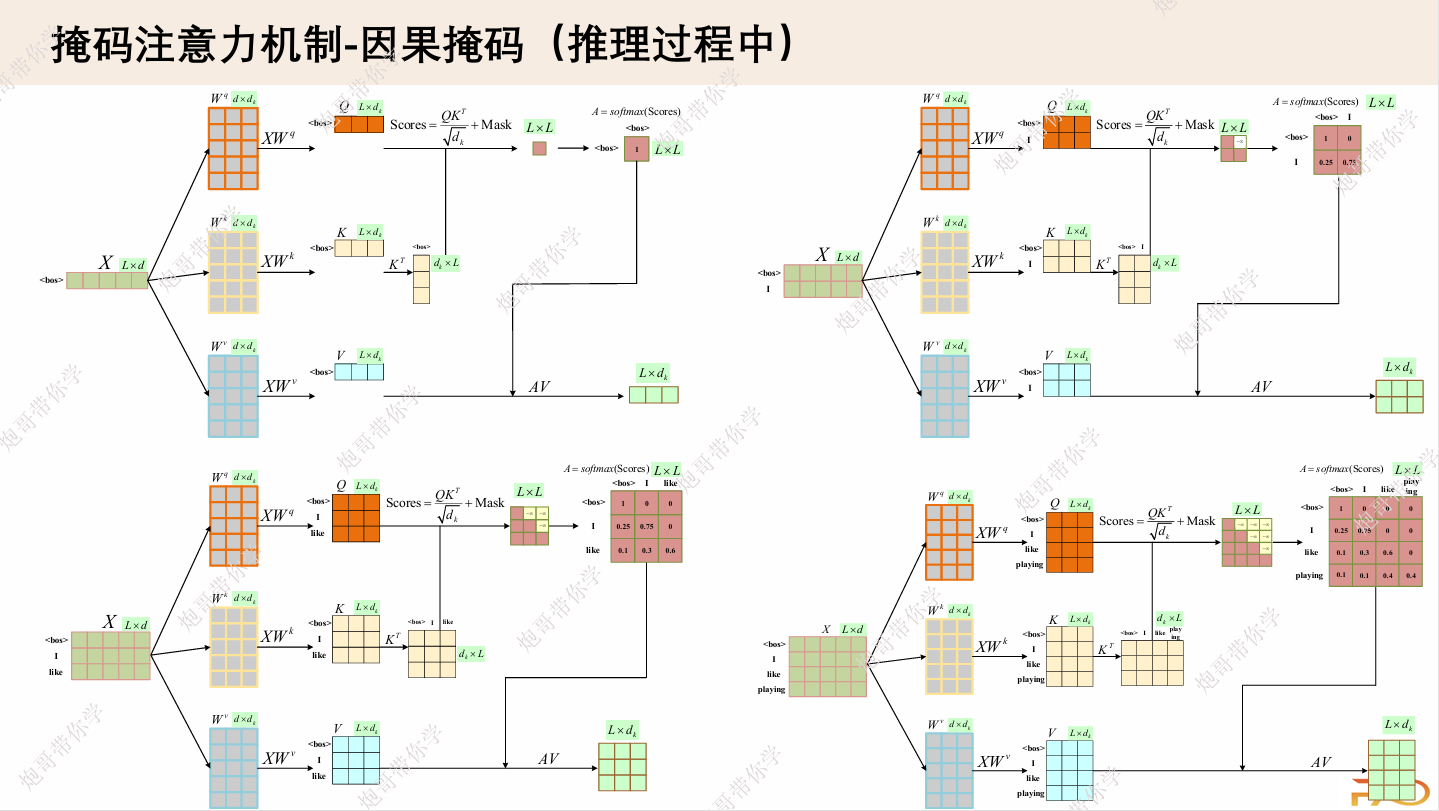
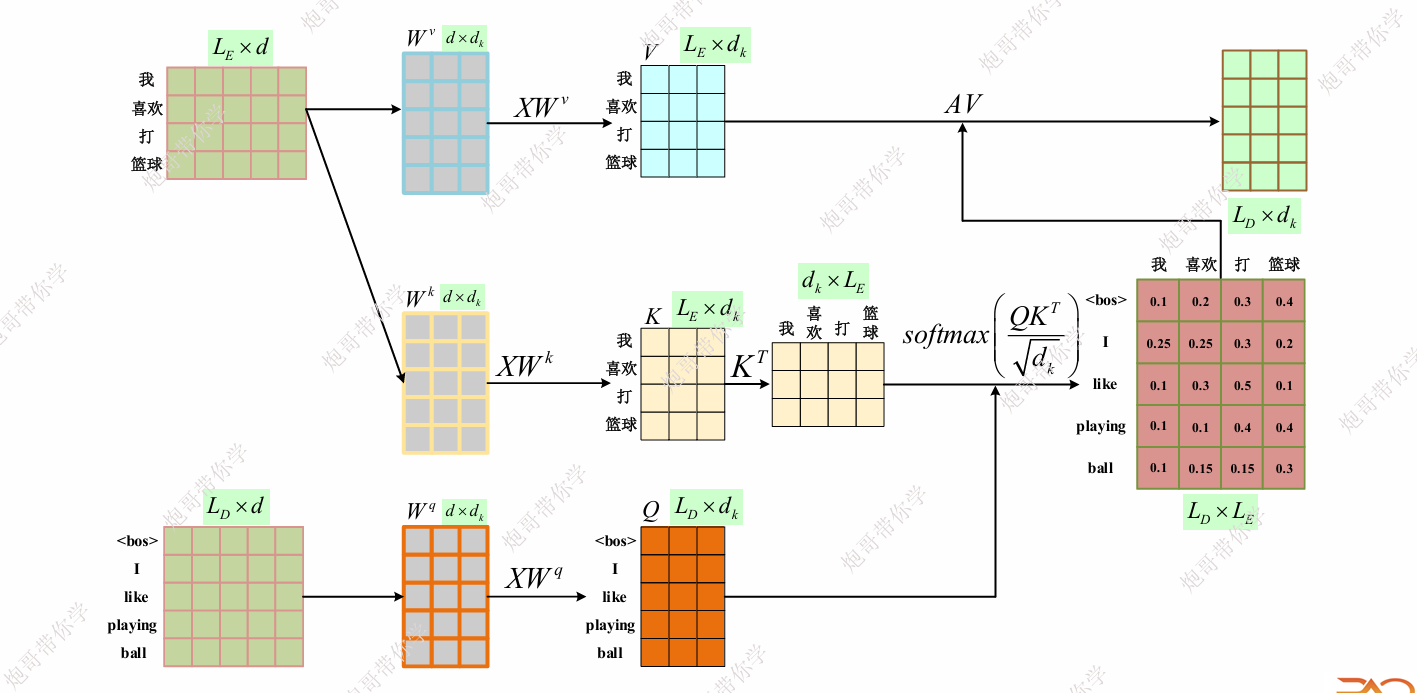
其中有三种注意力机制:编码器多头注意力、交叉注意力、解码器多头注意力(含因果编码)
# 输入数据
Transformer 里计算的全是数值,在输出之后和输出之前,都要把词转换为词向量,或者将词词向量转化为词。
# 词嵌入(Word Embedding)
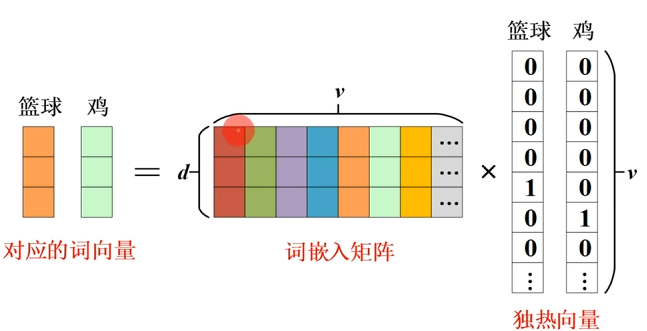
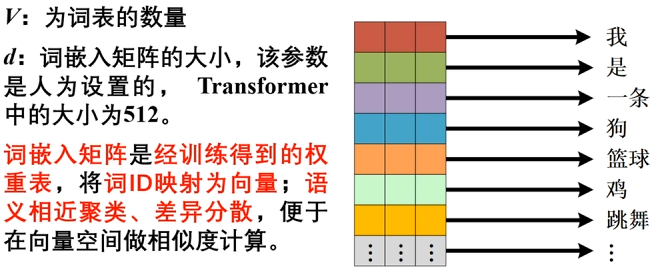
这个词嵌入矩阵的 d 相当于压缩后词向量的大小(维度)。
# 位置编码(Positional Encoding)
# 自注意力机制
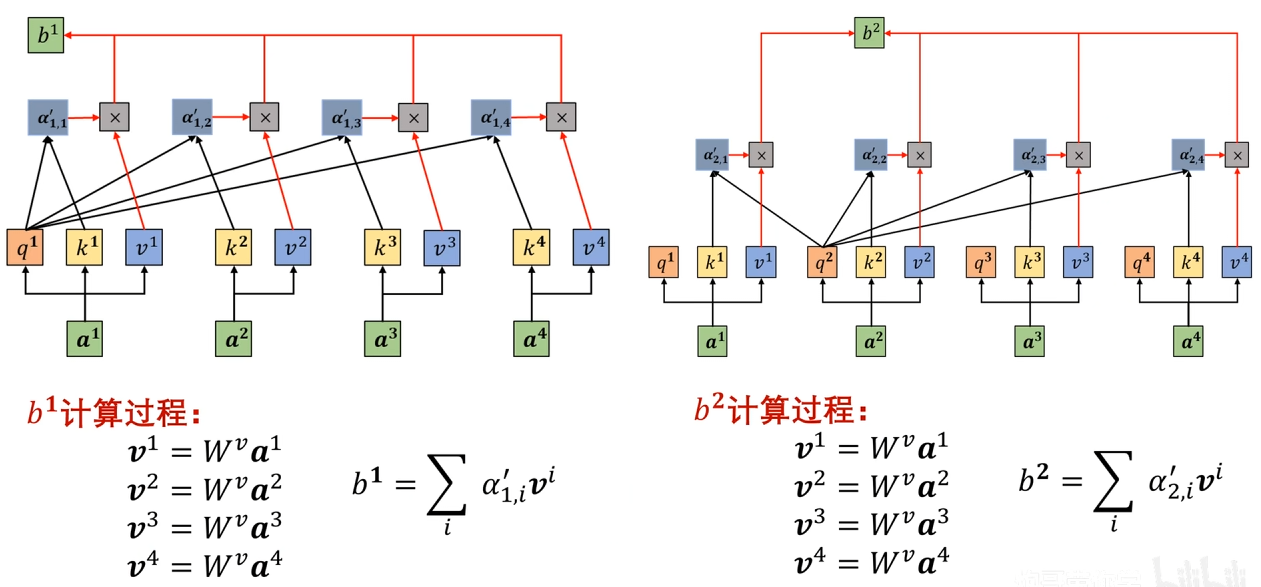
自注意力机制让每个输入位置都能动态地根据与其他位置的相关性重新表示自己,从而实现了信息的全局建模与动态加权融合。
# 多头注意力机制
# 掩码注意力(推理)
# 交叉注意力
# 参考文献
- 【Transformer 算法原理与实战】https://www.bilibili.com/video/BV1ej1EBWEWu
