# RAG 与向量数据库
以下内容基于开源项目 All in Rag:https://github.com/datawhalechina/all-in-rag,如果感兴趣的话可以 star+fork 学习。
# 文本分块
question:为什么要文本分块?
- Embedding Model 有严格的输入长度上限,超出此限制的文本块在输入时都会被截断,导致信息丢失,生成的向量也无法完整代表原文的语义。
- LLM 同样有上下文窗口限制,如果单个块过大,可能会导致只能容纳少数几个相关的块,限制了 LLM 回答问题时可参考的信息广度
question:是不是越大越好?
块的大小并非越大越好,过大的块会严重影响 RAG 系统的性能。也就是说可选择的越多,大模型越眼花缭乱,少量且正确的信息反而是关键。ABCDFG 的语义信息明显比 ABC 的语义信息包含的多,因此对 ABC 进行语义匹配的时候 ABC 的排名通常会高于 ABCDFG。
# 固定大小分块 CharacterTextSplitter
from langchain_text_splitters import CharacterTextSplitter | |
from langchain_community.document_loaders import TextLoader | |
loader = TextLoader("../data/fy.txt", encoding="utf-8") | |
docs = loader.load() | |
text_splitter = CharacterTextSplitter( | |
separator="\n\n", | |
chunk_size=200, | |
chunk_overlap=20 | |
) | |
chunks = text_splitter.split_documents(docs) |
# 递归字符分块 RecursiveCharacterTextSplitter
from langchain_text_splitters import RecursiveCharacterTextSplitter | |
from langchain_community.document_loaders import TextLoader | |
loader = TextLoader("../data/fy.txt", encoding="utf-8") | |
docs = loader.load() | |
text_splitter = RecursiveCharacterTextSplitter( | |
separators=["\n\n", "\n", "。", ",", " ", ""], # 分隔符优先级 | |
chunk_size=200, | |
chunk_overlap=10, | |
) | |
chunks = text_splitter.split_documents(docs) |
也可以支持针对不同语言进行分割,这个是对不同编程语言进行了优化:
from langchain_text_splitters import Language | |
# 针对代码文档的优化分隔符 | |
splitter = RecursiveCharacterTextSplitter.from_language( | |
language=Language.PYTHON, # 支持 Python、Java、C++ 等 | |
chunk_size=500, | |
chunk_overlap=50 | |
) |
递归字符分块的原理是采用一组有层次结构的分隔符(如段落、句子、单词)进行递归分割,旨在有效平衡语义完整性与块大小控制。在
RecursiveCharacterTextSplitter的实现中,该分块器首先尝试使用最高优先级的分隔符(如段落标记)来切分文本。如果切分后的块仍然过大,会继续对这个大块应用下一优先级分隔符(如句号),如此循环往复,直到块满足大小限制。这种分层处理的机制,能够在尽可能保持高级语义结构完整性的同时,有效控制块大小。
# 语义分块 SemanticChunker
import os | |
from dotenv import load_dotenv | |
from langchain.embeddings import init_embeddings | |
load_dotenv() | |
EMBED_MODEL_NAME = "BAAI/bge-m3" # 嵌入模型名称 | |
embedding_model = init_embeddings( | |
model="openai:" + EMBED_MODEL_NAME, | |
api_key=os.getenv("SILICONFLOW_API_KEY"), | |
base_url=os.getenv("SILICONFLOW_BASE_URL") | |
) | |
from langchain_experimental.text_splitter import SemanticChunker | |
text_splitter = SemanticChunker( | |
buffer_size=4, | |
embeddings=embedding_model, | |
breakpoint_threshold_type="percentile", # 断点识别方法 | |
sentence_split_regex=r'(?<=[。!?.!?])\s*', | |
breakpoint_threshold_amount=50, # 降低阈值,增加分块 | |
) | |
from langchain_community.document_loaders import PDFMinerLoader,TextLoader | |
from tqdm import tqdm | |
loader = TextLoader("../data/1.txt", encoding="utf-8") | |
documents = loader.load() | |
docs = text_splitter.split_documents(documents) |
断点识别方法 ( breakpoint_threshold_type ):
- percentile 百分位法:计算所有相邻句子的语义差异值,并将这些差异值进行排序。当一个差异值超过某个百分位阈值时,就认为该差异值是一个断点。breakpoint_threshold_amount (默认为 95),表示使用第 95 个百分位作为阈值。这意味着,只有最显著的 5% 的语义差异点会被选为切分点。
- standard_deviation 标准差法:计算所有差异值的平均值和标准差。当一个差异值超过 “平均值 + N * 标准差” 时,被视为异常高的跳跃,即断点。breakpoint_threshold_amount (默认为 3),表示使用 3 倍标准差作为阈值。
- interquartile 四分位距法:使用统计学中的四分位距(IQR)来识别异常值。当一个差异值超过 Q3 + N * IQR 时,被视为断点。breakpoint_threshold_amount (默认为 1.5),表示使用 1.5 倍的 IQR。
- gradient 梯度法:这是一种更复杂的方法。它首先计算差异值的变化率(梯度),然后对梯度应用百分位法。对于那些句子间语义联系紧密、差异值普遍较低的文本(如法律、医疗文档)特别有效,因为这种方法能更好地捕捉到语义变化的 “拐点”。breakpoint_threshold_amount (默认为 95)。
# 基于文档结构的分块 MarkdownHeaderTextSplitter
适用于 Markdown、HTML、LaTeX 等极具结构化的内容。
单纯按标题分割可能会导致一个问题:某个章节下的内容可能非常长,远超模型能处理的上下文窗口。为了解决这个问题, MarkdownHeaderTextSplitter 可以与其它分块器(如 RecursiveCharacterTextSplitter )组合使用。具体流程是:
- 使用
MarkdownHeaderTextSplitter将文档按标题分割成若干个大的、带有元数据的逻辑块。 - 对这些逻辑块再应用
RecursiveCharacterTextSplitter,将其进一步切分为符合chunk_size要求的小块。
这个是一个可视化分词工具:https://chunkviz.up.railway.app/
# 向量嵌入
question:Embedding 在干什么?
一句话来讲就是,把文本、图像、音频、视频等转换为数学上易于处理的、低维、稠密的连续数值向量。
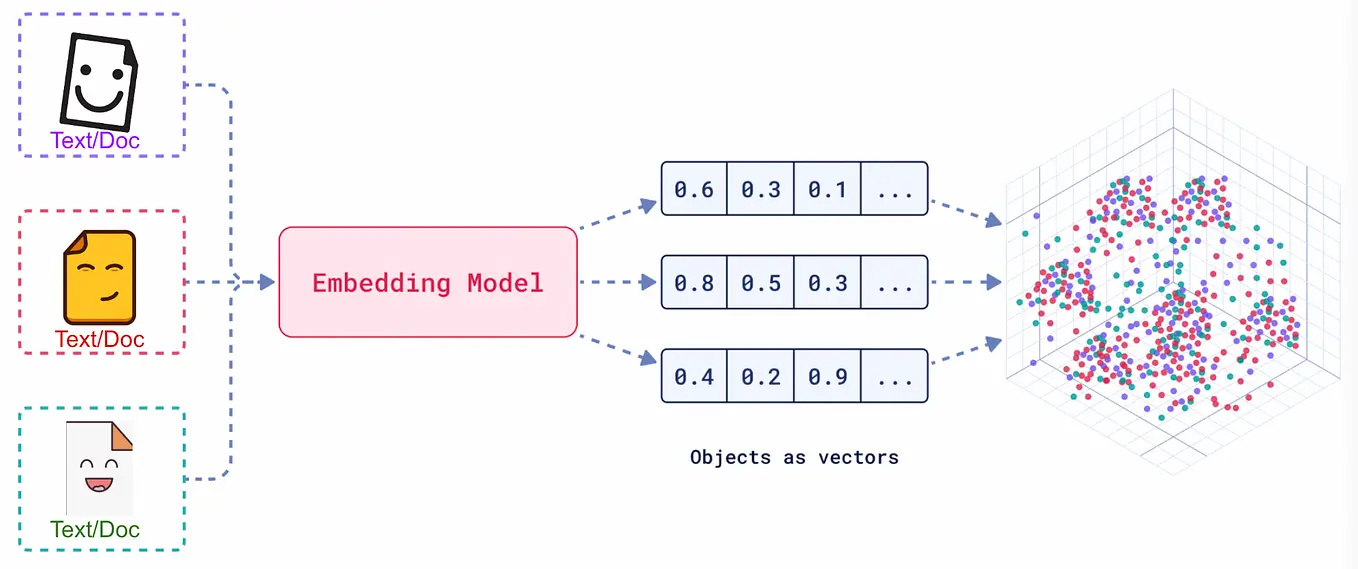
如果向量是杂乱的也无意义,经过 Embedding 之后数据是有语义的。通常使用以下数学方法来衡量向量间的 “距离” 或 “相似度”:
- 余弦相似度 Cosine Similarity(最常用)
- 点积 Dot Product
- 欧氏距离 Euclidean Distance
RAG 的语义检索以 Embedding 为核心,流程为:
- 先将文档切块并向量化存入向量数据库,查询时将问题也向量化
- 再计算问题向量与文档块向量的相似度
- 最后召回相似度最高的 Top-K 文档块,作为上下文与问题一起交给大模型生成答案。
Embedding 技术经历了三个阶段:
- 静态词嵌入:Word2Vec、GloVe 为每个词生成固定向量,但无法解决一词多义问题。
- 动态上下文嵌入:基于 Transformer 自注意力机制,同一个词在不同语境中生成不同向量,有效解决了多义性。
- RAG 驱动的新要求:
- 领域自适应:需通过微调或指令适应专业领域
- 多粒度与多模态:支持长文档、代码、图像、表格等多样输入
- 检索效率与混合检索:平衡存储成本与检索速度,结合语义与关键词匹配,如 BGE-M3
# 多模态嵌入
OpenAI 的 CLIP (Contrastive Language-Image Pre-training) 是一个很有影响力的模型,它为多模态嵌入定义了一个有效的范式。
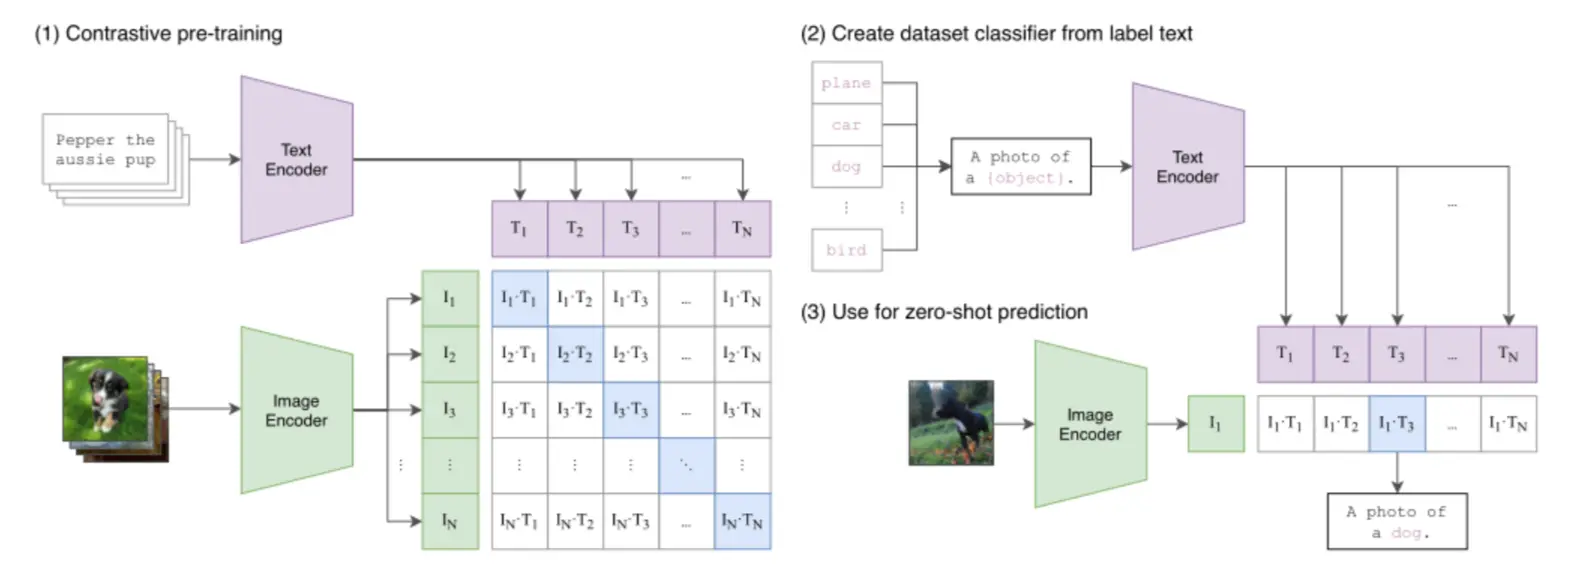
它采用双编码器架构 (Dual-Encoder Architecture),包含一个图像编码器和一个文本编码器,分别将图像和文本映射到同一个共享的向量空间中。
# 向量数据库 FAISS
FAISS 本质上是一个算法库,它将索引直接保存为本地文件(一个 .faiss 索引文件和一个 .pkl 映射文件),而非运行一个数据库服务。这种方式轻量且高效。
from langchain_openai import OpenAIEmbeddings | |
from langchain_core.documents import Document | |
from langchain_community.vectorstores import FAISS | |
import os | |
from dotenv import load_dotenv | |
load_dotenv() | |
embedding_model = OpenAIEmbeddings( | |
model="BAAI/bge-large-zh-v1.5", | |
api_key=os.getenv("SILICONFLOW_API_KEY"), | |
base_url=os.getenv("SILICONFLOW_BASE_URL"), | |
check_embedding_ctx_length=False, # 不检查长度 | |
) | |
texts = [ | |
"张三是法外狂徒", | |
"FAISS是一个用于高效相似性搜索和密集向量聚类的库。", | |
"LangChain是一个用于开发由语言模型驱动的应用程序的框架。" | |
] | |
docs = [Document(page_content=t) for t in texts] | |
vectorstore = FAISS.from_documents(docs, embedding_model) |
指定存储路径:
local_faiss_path = "./faiss_index_store" | |
vectorstore.save_local(local_faiss_path) |
以上称为为离线向量化,下面开始加载索引并执行查询。
# 3. 加载索引并执行查询 | |
# 加载时需指定相同的嵌入模型,并允许反序列化 | |
loaded_vectorstore = FAISS.load_local( | |
local_faiss_path, | |
embedding_model, | |
allow_dangerous_deserialization=True | |
) |
query = "FAISS是做什么的?" | |
results = loaded_vectorstore.similarity_search(query, k=1) | |
print(f"\n查询: '{query}'") | |
print("相似度最高的文档:") | |
for doc in results: | |
print(f"- {doc.page_content}") |
查询: ‘FAISS 是做什么的?’
相似度最高的文档:
- FAISS 是一个用于高效相似性搜索和密集向量聚类的库。
# 使用 LlamaIndex 做数据存储与检索
自定义 SiliconFlowEmbedding 类
from llama_index.core.embeddings import BaseEmbedding | |
from llama_index.core import Settings | |
from openai import OpenAI | |
from typing import List, Any, Optional | |
import os | |
from dotenv import load_dotenv | |
from pydantic import Field | |
load_dotenv() | |
class SiliconFlowEmbedding(BaseEmbedding): | |
"""自定义硅基流动嵌入类(兼容 LlamaIndex)""" | |
# 声明 Pydantic 字段 | |
model: str = Field(default="BAAI/bge-large-zh-v1.5", description="模型名称") | |
api_key: Optional[str] = Field(default=None, description="API密钥") | |
api_base: Optional[str] = Field(default=None, description="API基础URL") | |
_client: Any = None # 私有客户端 | |
def __init__( | |
self, | |
model: str = "BAAI/bge-large-zh-v1.5", | |
api_key: Optional[str] = None, | |
api_base: Optional[str] = None, | |
**kwargs: Any, | |
): | |
super().__init__( | |
model=model, | |
api_key=api_key or os.getenv("SILICONFLOW_API_KEY"), | |
api_base=api_base or os.getenv("SILICONFLOW_BASE_URL"), | |
**kwargs | |
) | |
# 初始化 OpenAI 客户端 | |
self._client = OpenAI( | |
api_key=self.api_key, | |
base_url=self.api_base | |
) | |
def _get_query_embedding(self, query: str) -> List[float]: | |
"""获取查询的嵌入""" | |
response = self._client.embeddings.create( | |
model=self.model, | |
input=query | |
) | |
return response.data[0].embedding | |
def _get_text_embedding(self, text: str) -> List[float]: | |
"""获取单个文本的嵌入""" | |
response = self._client.embeddings.create( | |
model=self.model, | |
input=text | |
) | |
return response.data[0].embedding | |
def _get_text_embeddings(self, texts: List[str]) -> List[List[float]]: | |
"""获取多个文本的嵌入""" | |
response = self._client.embeddings.create( | |
model=self.model, | |
input=texts | |
) | |
return [item.embedding for item in response.data] | |
async def _aget_query_embedding(self, query: str) -> List[float]: | |
"""异步获取查询的嵌入""" | |
return self._get_query_embedding(query) | |
async def _aget_text_embedding(self, text: str) -> List[float]: | |
"""异步获取文本的嵌入""" | |
return self._get_text_embedding(text) | |
# 使用自定义嵌入类 | |
embedding_model = SiliconFlowEmbedding( | |
model="BAAI/bge-large-zh-v1.5", | |
api_key=os.getenv("SILICONFLOW_API_KEY"), | |
api_base=os.getenv("SILICONFLOW_BASE_URL") | |
) | |
# 设置全局嵌入模型 | |
Settings.embed_model = embedding_model |
创建文档:
from llama_index.core import VectorStoreIndex, Document, Settings, StorageContext | |
Settings.embed_model = embedding_model | |
# 2. 创建示例文档 | |
texts = [ | |
"张三是法外狂徒", | |
"LlamaIndex是一个用于构建和查询私有或领域特定数据的框架。", | |
"它提供了数据连接、索引和查询接口等工具。" | |
] | |
docs = [Document(text=t) for t in texts] |
检索:
# 创建索引并持久化到本地 | |
index = VectorStoreIndex.from_documents(docs) | |
persist_path = "./llamaindex_index_store" | |
index.storage_context.persist(persist_dir=persist_path) | |
print(f"LlamaIndex 索引已保存至: {persist_path}") | |
from llama_index.core import StorageContext, load_index_from_storage | |
# 加载索引 | |
storage_context = StorageContext.from_defaults(persist_dir=persist_path) | |
loaded_index = load_index_from_storage(storage_context) | |
# 使用检索器(不需要 LLM) | |
retriever = loaded_index.as_retriever() | |
# 检索相关文档 | |
query = "LlamaIndex是做什么的?" | |
nodes = retriever.retrieve(query) | |
print(f"检索到 {len(nodes)} 个相关文档:") | |
for i, node in enumerate(nodes): | |
print(f"\n文档 {i+1}:") | |
print(node.text) | |
print(f"相似度分数: {node.score}") |
# 向量数据库 Milvus
这部分已在本站的 LangChain 文章中介绍过了,这里就不展开了。
