# YOLOv8 with Ultralytics Full Version
# 克隆与安装
git clone https://github.com/ultralytics/ultralytics.git |
conda install -c pytorch -c nvidia -c conda-forge pytorch torchvision pytorch-cuda=11.8 ultralytics |
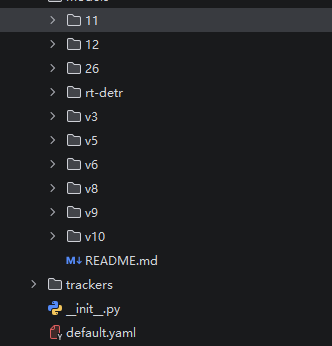
Ultralytics 根项目与之前纯粹的 v5 项目不同,它包含了全部的 YOLO 版本。
在根目录创建 detect.py:
from ultralytics import YOLO | |
model = YOLO("yolov8s.pt") | |
model.predict(source=0, show=True) |
三行代码即可调用摄像头检测。
通过:
model.info(verbose=True) | |
print(model.model) |
即可查看模型结构:
YOLOv8s summary: 129 layers, 11,166,560 parameters, 0 gradients | |
DetectionModel( | |
(model): Sequential( | |
(0): Conv( | |
(conv): Conv2d(3, 32, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(32, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(1): Conv( | |
(conv): Conv2d(32, 64, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(2): C2f( | |
(cv1): Conv( | |
(conv): Conv2d(64, 64, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(96, 64, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(m): ModuleList( | |
(0): Bottleneck( | |
(cv1): Conv( | |
(conv): Conv2d(32, 32, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(32, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(32, 32, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(32, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
) | |
) | |
) | |
(3): Conv( | |
(conv): Conv2d(64, 128, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(4): C2f( | |
(cv1): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(256, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(m): ModuleList( | |
(0-1): 2 x Bottleneck( | |
(cv1): Conv( | |
(conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
) | |
) | |
) | |
(5): Conv( | |
(conv): Conv2d(128, 256, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(6): C2f( | |
(cv1): Conv( | |
(conv): Conv2d(256, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(512, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(m): ModuleList( | |
(0-1): 2 x Bottleneck( | |
(cv1): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
) | |
) | |
) | |
(7): Conv( | |
(conv): Conv2d(256, 512, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(512, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(8): C2f( | |
(cv1): Conv( | |
(conv): Conv2d(512, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(512, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(768, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(512, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(m): ModuleList( | |
(0): Bottleneck( | |
(cv1): Conv( | |
(conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
) | |
) | |
) | |
(9): SPPF( | |
(cv1): Conv( | |
(conv): Conv2d(512, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(1024, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(512, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(m): MaxPool2d(kernel_size=5, stride=1, padding=2, dilation=1, ceil_mode=False) | |
) | |
(10): Upsample(scale_factor=2.0, mode='nearest') | |
(11): Concat() | |
(12): C2f( | |
(cv1): Conv( | |
(conv): Conv2d(768, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(384, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(m): ModuleList( | |
(0): Bottleneck( | |
(cv1): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
) | |
) | |
) | |
(13): Upsample(scale_factor=2.0, mode='nearest') | |
(14): Concat() | |
(15): C2f( | |
(cv1): Conv( | |
(conv): Conv2d(384, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(192, 128, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(m): ModuleList( | |
(0): Bottleneck( | |
(cv1): Conv( | |
(conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
) | |
) | |
) | |
(16): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(17): Concat() | |
(18): C2f( | |
(cv1): Conv( | |
(conv): Conv2d(384, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(384, 256, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(m): ModuleList( | |
(0): Bottleneck( | |
(cv1): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
) | |
) | |
) | |
(19): Conv( | |
(conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(20): Concat() | |
(21): C2f( | |
(cv1): Conv( | |
(conv): Conv2d(768, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(512, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(768, 512, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
(bn): BatchNorm2d(512, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(m): ModuleList( | |
(0): Bottleneck( | |
(cv1): Conv( | |
(conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(cv2): Conv( | |
(conv): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(256, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
) | |
) | |
) | |
(22): Detect( | |
(cv2): ModuleList( | |
(0): Sequential( | |
(0): Conv( | |
(conv): Conv2d(128, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(1): Conv( | |
(conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(2): Conv2d(64, 64, kernel_size=(1, 1), stride=(1, 1)) | |
) | |
(1): Sequential( | |
(0): Conv( | |
(conv): Conv2d(256, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(1): Conv( | |
(conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(2): Conv2d(64, 64, kernel_size=(1, 1), stride=(1, 1)) | |
) | |
(2): Sequential( | |
(0): Conv( | |
(conv): Conv2d(512, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(1): Conv( | |
(conv): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(64, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(2): Conv2d(64, 64, kernel_size=(1, 1), stride=(1, 1)) | |
) | |
) | |
(cv3): ModuleList( | |
(0): Sequential( | |
(0): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(1): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(2): Conv2d(128, 80, kernel_size=(1, 1), stride=(1, 1)) | |
) | |
(1): Sequential( | |
(0): Conv( | |
(conv): Conv2d(256, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(1): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(2): Conv2d(128, 80, kernel_size=(1, 1), stride=(1, 1)) | |
) | |
(2): Sequential( | |
(0): Conv( | |
(conv): Conv2d(512, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(1): Conv( | |
(conv): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1), bias=False) | |
(bn): BatchNorm2d(128, eps=0.001, momentum=0.03, affine=True, track_running_stats=True) | |
(act): SiLU(inplace=True) | |
) | |
(2): Conv2d(128, 80, kernel_size=(1, 1), stride=(1, 1)) | |
) | |
) | |
(dfl): DFL( | |
(conv): Conv2d(16, 1, kernel_size=(1, 1), stride=(1, 1), bias=False) | |
) | |
) | |
) | |
) |
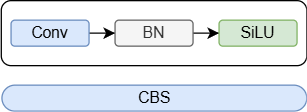
这模型我说白了,打眼一看就是 CBS、CBS、CBS…
# 看看模型
大部分内容与之前的版本大差不差,详情可看我之前的文章。
# CBS
class Conv(nn.Module): | |
"""Standard convolution module with batch normalization and activation. | |
Attributes: | |
conv (nn.Conv2d): Convolutional layer. | |
bn (nn.BatchNorm2d): Batch normalization layer. | |
act (nn.Module): Activation function layer. | |
default_act (nn.Module): Default activation function (SiLU). | |
""" | |
default_act = nn.SiLU() # default activation | |
def __init__(self, c1, c2, k=1, s=1, p=None, g=1, d=1, act=True): | |
"""Initialize Conv layer with given parameters. | |
Args: | |
c1 (int): Number of input channels. | |
c2 (int): Number of output channels. | |
k (int): Kernel size. | |
s (int): Stride. | |
p (int, optional): Padding. | |
g (int): Groups. | |
d (int): Dilation. | |
act (bool | nn.Module): Activation function. | |
""" | |
super().__init__() | |
self.conv = nn.Conv2d(c1, c2, k, s, autopad(k, p, d), groups=g, dilation=d, bias=False) | |
self.bn = nn.BatchNorm2d(c2) | |
self.act = self.default_act if act is True else act if isinstance(act, nn.Module) else nn.Identity() | |
def forward(self, x): | |
"""Apply convolution, batch normalization and activation to input tensor. | |
Args: | |
x (torch.Tensor): Input tensor. | |
Returns: | |
(torch.Tensor): Output tensor. | |
""" | |
return self.act(self.bn(self.conv(x))) | |
def forward_fuse(self, x): | |
"""Apply convolution and activation without batch normalization. | |
Args: | |
x (torch.Tensor): Input tensor. | |
Returns: | |
(torch.Tensor): Output tensor. | |
""" | |
return self.act(self.conv(x)) |
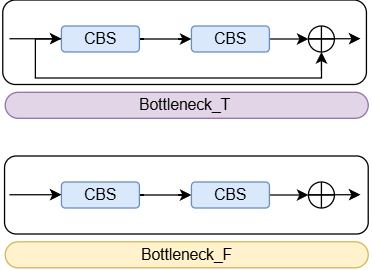
# Bottleneck_T and Bottleneck_F
class Bottleneck(nn.Module): | |
"""Standard bottleneck.""" | |
def __init__( | |
self, c1: int, c2: int, shortcut: bool = True, g: int = 1, k: tuple[int, int] = (3, 3), e: float = 0.5 | |
): | |
"""Initialize a standard bottleneck module. | |
Args: | |
c1 (int): Input channels. | |
c2 (int): Output channels. | |
shortcut (bool): Whether to use shortcut connection. | |
g (int): Groups for convolutions. | |
k (tuple): Kernel sizes for convolutions. | |
e (float): Expansion ratio. | |
""" | |
super().__init__() | |
c_ = int(c2 * e) # hidden channels | |
self.cv1 = Conv(c1, c_, k[0], 1) | |
self.cv2 = Conv(c_, c2, k[1], 1, g=g) | |
self.add = shortcut and c1 == c2 | |
def forward(self, x: torch.Tensor) -> torch.Tensor: | |
"""Apply bottleneck with optional shortcut connection.""" | |
return x + self.cv2(self.cv1(x)) if self.add else self.cv2(self.cv1(x)) |
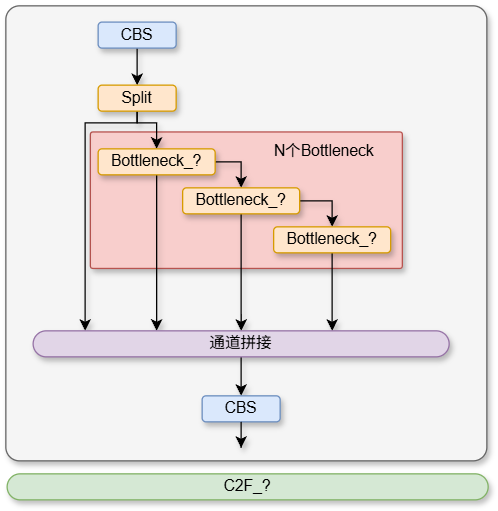
# C2F_T and C2F_F
class C2f(nn.Module): | |
"""Faster Implementation of CSP Bottleneck with 2 convolutions.""" | |
def __init__(self, c1: int, c2: int, n: int = 1, shortcut: bool = False, g: int = 1, e: float = 0.5): | |
"""Initialize a CSP bottleneck with 2 convolutions. | |
Args: | |
c1 (int): Input channels. | |
c2 (int): Output channels. | |
n (int): Number of Bottleneck blocks. | |
shortcut (bool): Whether to use shortcut connections. | |
g (int): Groups for convolutions. | |
e (float): Expansion ratio. | |
""" | |
super().__init__() | |
self.c = int(c2 * e) # hidden channels | |
self.cv1 = Conv(c1, 2 * self.c, 1, 1) | |
self.cv2 = Conv((2 + n) * self.c, c2, 1) # optional act=FReLU(c2) | |
self.m = nn.ModuleList(Bottleneck(self.c, self.c, shortcut, g, k=((3, 3), (3, 3)), e=1.0) for _ in range(n)) | |
def forward(self, x: torch.Tensor) -> torch.Tensor: | |
"""Forward pass through C2f layer.""" | |
y = list(self.cv1(x).chunk(2, 1)) | |
y.extend(m(y[-1]) for m in self.m) | |
return self.cv2(torch.cat(y, 1)) | |
def forward_split(self, x: torch.Tensor) -> torch.Tensor: | |
"""Forward pass using split() instead of chunk().""" | |
y = self.cv1(x).split((self.c, self.c), 1) | |
y = [y[0], y[1]] | |
y.extend(m(y[-1]) for m in self.m) | |
return self.cv2(torch.cat(y, 1)) |
chunk(2, 1): y = list(self.cv1(x).chunk(2, 1)) 在通道维度平均切成两份。 - [-1, 6, C2f, [256, True]] 这里有如果 6 个 Bottleneck。就像这样: self.m = [B1, B2, B3, B4, B5, B6] 。观察: y.extend(m(y[-1]) for m in self.m) ,刚 chunk 后使用的是后一半,第一次 Bottleneck 后使用的是 B1 (),第二次执行后使用的是 B2 (B1 ())。大概是这样:
[x] | |
[x1, x2] # chunk 后 | |
[x1, x2, B1(x2)] # 第一次 y.extend (m (y [-1]) for m in self.m) | |
[x1, x2, B1(x2), B2(B1(x2))] # 第二次 y.extend (m (y [-1]) for m in self.m) | |
...... | |
[x1, x2, B1(x2), B2(B1(x2)), B3(B2(B1(x2))),.... , B6(B5(B4(B3(B2(B1(x2))))))] # 第六次 |
最后:
return self.cv2(torch.cat(y, 1)) |
把那个列表全拼起来了。牛逼!优雅的代码,太优雅了!
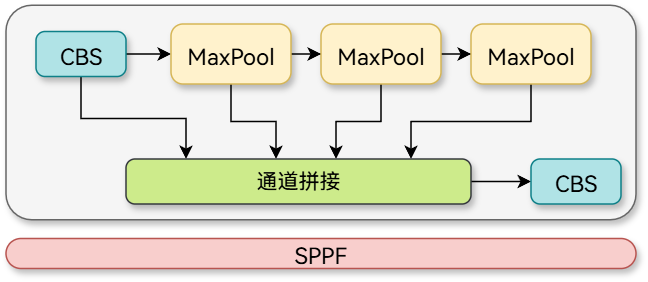
# SPPF
class SPPF(nn.Module): | |
"""Spatial Pyramid Pooling - Fast (SPPF) layer for YOLOv5 by Glenn Jocher.""" | |
def __init__(self, c1: int, c2: int, k: int = 5, n: int = 3, shortcut: bool = False): | |
"""Initialize the SPPF layer with given input/output channels and kernel size. | |
Args: | |
c1 (int): Input channels. | |
c2 (int): Output channels. | |
k (int): Kernel size. | |
n (int): Number of pooling iterations. | |
shortcut (bool): Whether to use shortcut connection. | |
Notes: | |
This module is equivalent to SPP(k=(5, 9, 13)). | |
""" | |
super().__init__() | |
c_ = c1 // 2 # hidden channels | |
self.cv1 = Conv(c1, c_, 1, 1, act=False) | |
self.cv2 = Conv(c_ * (n + 1), c2, 1, 1) | |
self.m = nn.MaxPool2d(kernel_size=k, stride=1, padding=k // 2) | |
self.n = n | |
self.add = shortcut and c1 == c2 | |
def forward(self, x: torch.Tensor) -> torch.Tensor: | |
"""Apply sequential pooling operations to input and return concatenated feature maps.""" | |
y = [self.cv1(x)] | |
y.extend(self.m(y[-1]) for _ in range(getattr(self, "n", 3))) | |
y = self.cv2(torch.cat(y, 1)) | |
return y + x if getattr(self, "add", False) else y |
这个 cv1 和 cv2 中的 k 与 s 全是 1,完全不改变特征图大小,只改变通道数。通道拼接这里接受了四部分的输入,所以 self.cv2 = Conv(c_ * 4, c2, 1, 1) 中写道: c_ * 4 ,其中 c_ 是第一个 CBS 的输出通道数。
# Anchor-Free!
终于把你盼来了哈哈哈,先回顾 Anchor-Based,YOLOv5 的检测头会:
- 在每个网格点上
- 预设 3 个 anchor(比如 10×13, 16×30, 33×23)
- 预测:x 偏移、y 偏移、w 缩放、h 缩放。
也就是说:预测是基于 “某个预设框” 进行修正,就像这样:
bx = sigmoid(tx) + cx | |
bw = anchor_w * exp(tw) |
YOLOv8 不再使用 anchor,每个特征点直接预测,每个点自己决定是不是目标中心,那 YOLOv1 当年不也是没 anchor 吗?有啥本质区别?哈哈表面一样,内核完全不同。YOLOv8 是点 + 分布建模 + 动态匹配。YOLOv8 中心点是固定网格点,但预测框的位置完全由 ltrb 决定。
YOLOv8:
- 每个特征点都是候选中心
- 预测的是 l, t, r, b(到边界的距离)
- 用 DFL 分布回归
- 动态正负样本分配
相当于特征图上有很多钉子,每个钉子可以向四周拉橡皮筋,谁拉得最准,谁就负责那个目标,我觉得这是最精彩的部分啦!
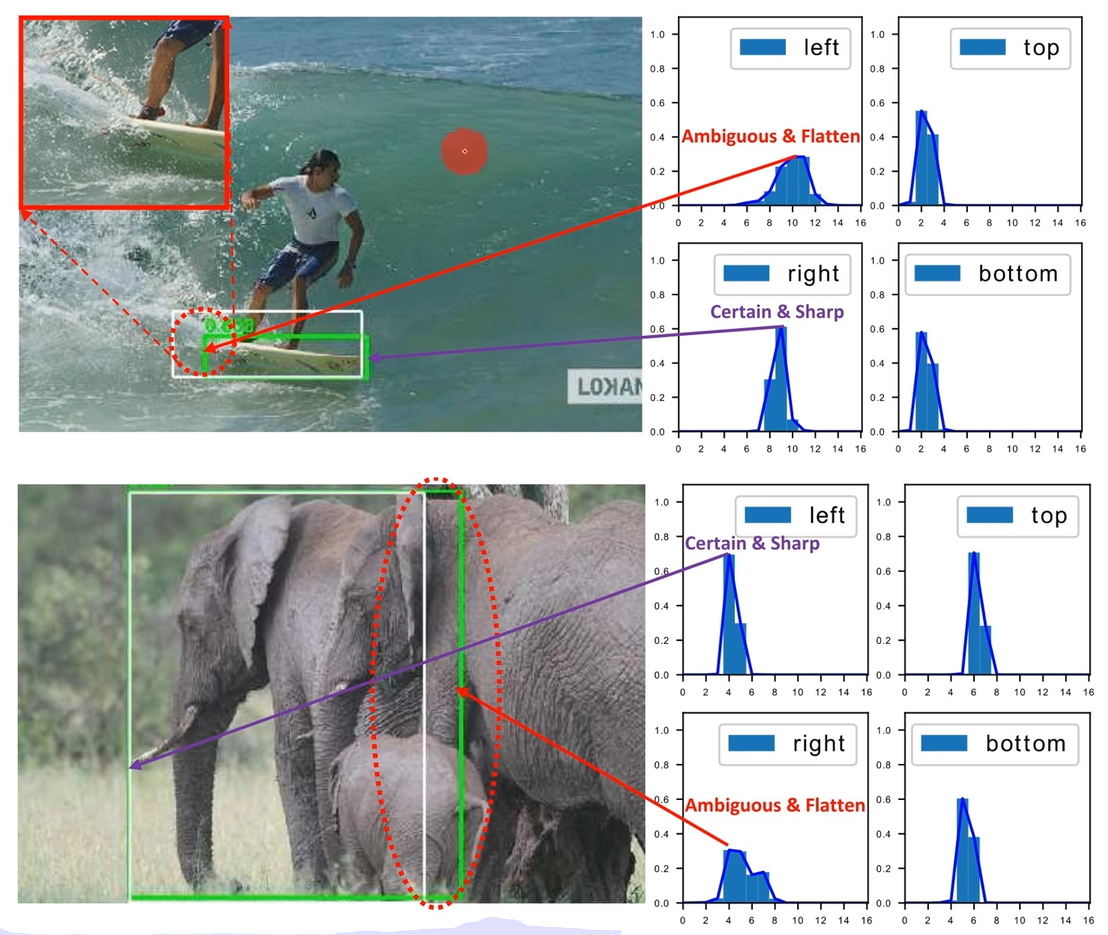
YOLOv8 觉得:“我为什么要难为模型去猜一个无限精确的点呢?我给它 16 个固定的刻度,让它去做选择题。” 这 16 个值代表距离 ,模型输出的是这 16 个刻度的概率分布,就是有点像模糊数学,大概是那样。你可能会想,如果我只需要 左右两个点,为什么要输出 16 个值?因为模型在推理阶段并不知道真实值在哪。它必须在 16 个刻度上全部分布概率,最后通过 “算出” 那个它认为最可能的距离。
在 YOLOv8 中,一个方向的实际预测距离(像素)计算公式是:实际像素距离 =DFL 得到的数值 × 当前层的步长。YOLOv8 有三个主要的输出层,每一层负责不同大小的物体。
我们来看最精细的那一层 P3:
- P3 层的步长:8,意味着特征图缩小了 8 倍。
- DFL 最大刻度:15。
- 最大覆盖距离: 像素。
| 特征图层级 | 步长 | DFL 最大刻度 | 单向最大覆盖 | 整个框的最大尺寸 |
|---|---|---|---|---|
| P3 | 8 | 15 | 15 \times 8 = \mathbf | 约 240 像素 |
| P4 | 16 | 15 | 15 \times 16 = \mathbf | 约 480 像素 |
| P5 | 32 | 15 | 15 \times 32 = \mathbf | 约 960 像素 |
# DFL
普通回归预测一个值:模型说 “距离是 5.4”。如果实际是 5.7,它只知道自己错了,但不知道边缘到底在哪。DFL 预测分布:模型说 “我有 60% 把握在 5,40% 把握在 6”。
想象你要测量一个物体的长度,我有两种给工具的方式:
方式 A:给你一张白纸,让你自己猜长度并写下来。
方式 B:给你一把有 16 个刻度 的尺子,让你告诉我,物体的边缘落在哪个刻度上。为什么方式 B 更好? 因为神经网络本质上是一个巨大的分类器。让它从 16 个选项里选(分类),比让它凭空变出一个精准的浮点数(回归)要容易得多。
DFL 的核心思想是将连续的坐标值离散化,YOLOv8 默认将边界框的偏移量划分为 个整数槽位。对于每一个边缘,模型会输出 个值,代表落在这 个位置上的概率。
: 标签(Ground Truth)经过缩放后的浮点坐标。
: 两侧最近的整数节点。
: 模型预测落在这些节点上的网络输出。
这种分布的形式能够表达不确定性,让模型在面对复杂场景时表现得更加稳健。
为什么 DFL 公式里只用 和 ,即 左右两边的概率?因为既然 落在 和 之间,那我们希望模型预测的概率也集中在这两个点上。如果 和 很大,说明模型预测得非常精准且集中。如果模型在 或 上给出了高概率,即便加权平均后的期望值 对了,DFL 也会跳出来大喊:“不对!你预测得太离散了,不确定性太高,罚!”
# 匹配的三步走
TAL 会计算每一个候选中心点的得分 ,公式如下:
分类得分: 这个点预测出的类别对不对?概率高不高?
定位得分: 这个点用 DFL 预测出来的框,跟真实物体的框重合度高不高?
: 权重参数,用来平衡分类和定位的重要性。
第一步,初步筛选:首先,模型会设定一个范围。只有落入物体真实框内的中心点,才有资格参加海选。
第二步,动态打分:对所有入围的点,根据上面的公式计算得分 。
- 如果一个点在物体的边缘,它预测的框可能很歪,得分就低。
- 如果一个点在物体的正中心,它预测的框通常很准,得分就高。
第三步,择优录取:
对于每一个真实物体,TAL 会选择得分最高的 前 K 个点 作为正样本。
- 正样本:负责计算分类损失、IoU 损失和 DFL 损失。
- 负样本:剩下的所有
# 损失函数
分类损失:用的是 VFL, 定位损失:用的是 CIoU,:用的是 DFL。
# 参考
- 【yolov8 目标检测原理与实战】https://www.bilibili.com/video/BV19nrbYjEyN
- 【ultralytics doc】https://docs.ultralytics.com/
- 【conda】https://anaconda.org/channels/conda-forge/packages/ultralytics/overview
